新同事 3 周做出分析助手,真正说明的不是他会写 Prompt
Lyft 把 Analytics & Rides Intelligence Assistant 交给新工程师作为入职项目,并在 3 周内推进到生产环境。真正值得数据从业者注意的,不是 Prompt 写得多快,而是认证、可观测性、状态管理、流式响应和内部文档是否已经铺成一条新人能走通的路。
 PRO
AI 问数成本守门清单:限制查询风暴、重复试探和高价重跑
AI 问数进入生产后,一次自然语言任务可能拆成大量 SQL,并在字段猜错、结果为空或多 Agent 探索时反复重跑。本文给出一套 Pro 成本守门清单,从任务预算、查询估价、并发与扫描限制,到缓存复用、取消传播和逐问题账单,帮助数据团队防住查询风暴。
AI 查一次数跑上千条 SQL,数据库扛得住吗?
Berkeley BAIR 讨论 Agent 成为数据库新用户后,一次根因分析可能展开成上千条 SQL,且多 Agent 实验里只有约 10%–20% 的子计划真正不同。做 AI 问数的团队如果只验最终答案,不看重复查询、并发、扫描量和取消机制,数据库会先替模型交学费。
一个 MCP 工具有 14 个参数,AI 为什么越用越糊涂?
AWS 用同一个后端比较了 6 种 MCP 工具设计:原样暴露 14 个内部参数时,AI 会猜错合法值并反复重试;改成业务化命名、枚举、默认值和按需加载后,调用更稳定。数据开发给内部 API 接 MCP 时,怎样避免把旧接口的复杂度搬给 Agent?
每次问 AI 都要从头解释,是你的工作还没有留下“说明书”
很多数据分析师和数据开发已经开始用 AI 写 SQL、查资料、整理分析,但每次提问都要重新解释业务背景、指标口径和项目约束。问题不一定是 AI 记性差,而是你的工作没有沉淀成说明书。本文从普通数据从业者视角,讲怎么把反复解释的内容变成可复用的项目说明、指标说明和判断记录。
AI 模型再聪明,也救不了一条喂不动的数据链路
很多数据分析师和数据开发以为 AI 项目卡住,是模型不够聪明、Prompt 不够好。Meta 的 AI Storage Blueprint 提醒了另一件事:模型能不能发挥作用,取决于数据能不能稳定、及时、可追溯地喂进去。本文从普通数据从业者视角,拆解为什么数据链路比模型演示更早决定 AI 项目的上限。
AI Agent 进公司流程前,谁来给它踩刹车?
Microsoft 2026 Work Trend Index 把企业推向 Frontier Firm,Databricks 也开始强调治理 AI agents 能做什么。对数据团队来说,Agent 进公司流程前最该问的不是能不能自动跑,而是谁给它身份、权限、审批和日志边界?
 PRO
语义层不是新名词,是 AI 时代的数据说明书
很多数据团队一听语义层,就想到老 BI、指标平台和数据治理文档。但 Power BI、Databricks、MIT 和 Lyft 最近都在重新谈 semantic layer。对数据分析师和数据工程师来说,真正的问题是:怎么从 20 个高频业务问题开始,把指标、维度、权限、质量和拒答规则写成 AI 能调用的数据说明书?
AI 问数最先暴露的,是公司没有一本指标说明书
很多公司做 AI 问数时,先关心模型会不会写 SQL,却忽略了一个更普通的问题:公司有没有一本能说明指标口径、数据来源、权限边界和适用场景的指标说明书?对数据分析师和 BI 同学来说,AI 最先暴露的往往不是模型能力,而是组织没有把业务语义写下来。
报表以后可能不是给人看的,而是给 AI 调用的
Power BI、Databricks 和 MIT 最近都在把语义模型、治理台和 GenAI 放到一起讲。对数据分析师和 BI 同学来说,问题不只是报表会不会被 AI 取代,而是你的指标、权限、口径和解释,能不能变成 AI 也能调用的业务接口?
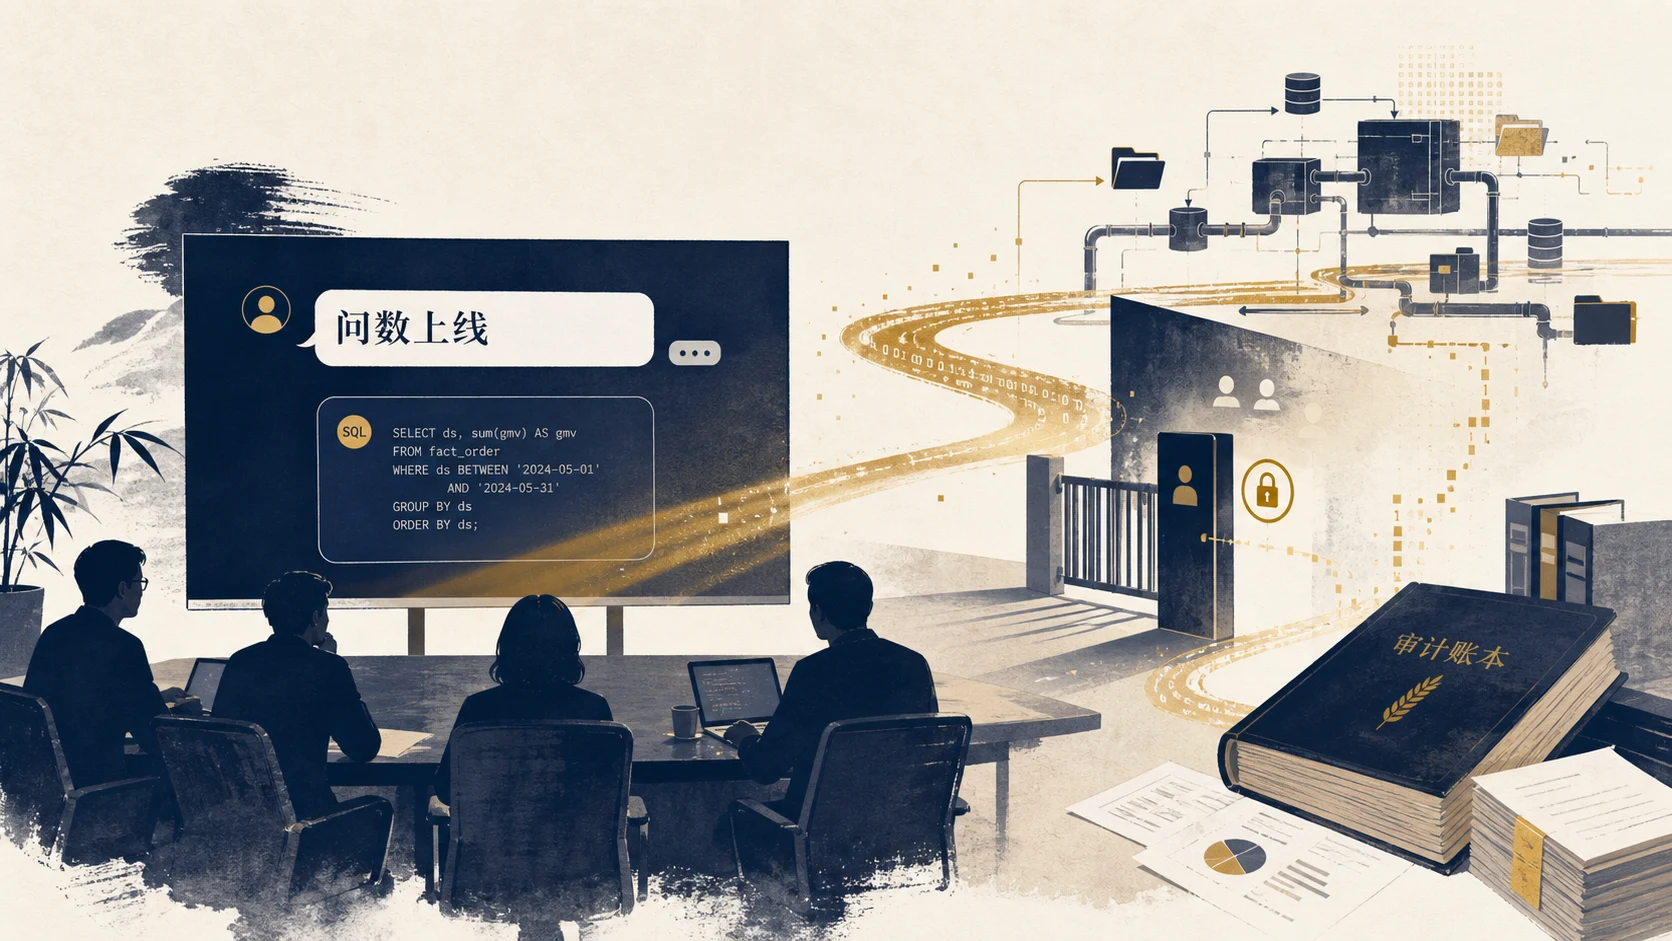
AI 问数 Demo 很顺,为什么一上线就翻车?
AI 问数和 Text-to-SQL Demo 往往很顺:输入一句话,模型生成 SQL,图表立刻出现。但一到真实企业上线,就会遇到权限、口径、表名、脏数据和责任边界。本文从一次上线评审讲起,拆解 AI 问数翻车的 4 个原因,以及上线前必须补的 5 个基础动作。
AI 写 SQL 越快,数据人越容易背锅
AI 问数和 Text-to-SQL 正在进入数据团队,但数据分析师、数据开发和 BI 同学真正要担心的,不是模型不会写 SQL,而是它写得太顺、错得太像对。本文从一次指标复盘会讲起,拆开 AI 写 SQL 的 3 类背锅风险、1 段 SQL 对照、10 项上线检查和 20 个高频问题模板。