
上游只改 1 个字段,17 张报表一起报错:先查哪 3 层依赖
上游团队只把 customer_level 改成 member_level,为什么 17 张经营报表会同时报错?本文从数据负责人收到告警的现场出发,拆开存储模型、加工任务与指标消费 3 层依赖,给出字段变更后的影响分析顺序、止损动作和变更记录方法,让数据工程团队先找准受影响范围再修。

数据周刊|Spark 4.2 把 CDC 写进内核,补丁也要先过 SQL
本期关注 2026 年 7 月 13—19 日的 3 个一手信号:Apache Spark 4.2 正式加入 CDC、指标视图与地理类型;Google BigQuery 预览全局数据治理标签;AWS 给 Redshift 补丁加上约 35 条目录查询和真实负载回归。数据开发下周该先验证什么?
把数据湖换成 Iceberg 前,先找出最值得迁的 3 张表
Grab 把 Hive Parquet 迁往 Apache Iceberg 后,部分查询从约 70 秒降到 6 秒,部分 S3 API 成本最多下降约 95%。但普通数据开发不该先问要不要全湖迁移,而应从小文件、查询频率、元数据等待和人工补分区里找出最值得先动的 3 张表。
 PRO
Iceberg 迁移决策表:从小文件、查询成本到回滚计划
团队准备从 Hive Parquet 迁往 Apache Iceberg 时,最容易缺的不是技术介绍,而是一张能比较收益、兼容性和回滚风险的决策表。本文给数据开发一套 Pro 模板,用 6 组指标筛选候选表,并把基线、试点、双读验证和退出条件写进迁移计划。
数据周刊|Agent 开始改写数据库、图表和分析助手
Data Engineering Weekly #278 把 5 个信号放到了一起:Agent 可能一次发出上千条 SQL,Microsoft Flint 尝试让 AI 稳定生成图表,Grab 用 Apache Iceberg 处理海量小文件,AWS 重做 MCP 工具接口。普通数据开发和分析师该先补哪一层?
上线前多重放 1 次历史数据,可能少背 3 次锅
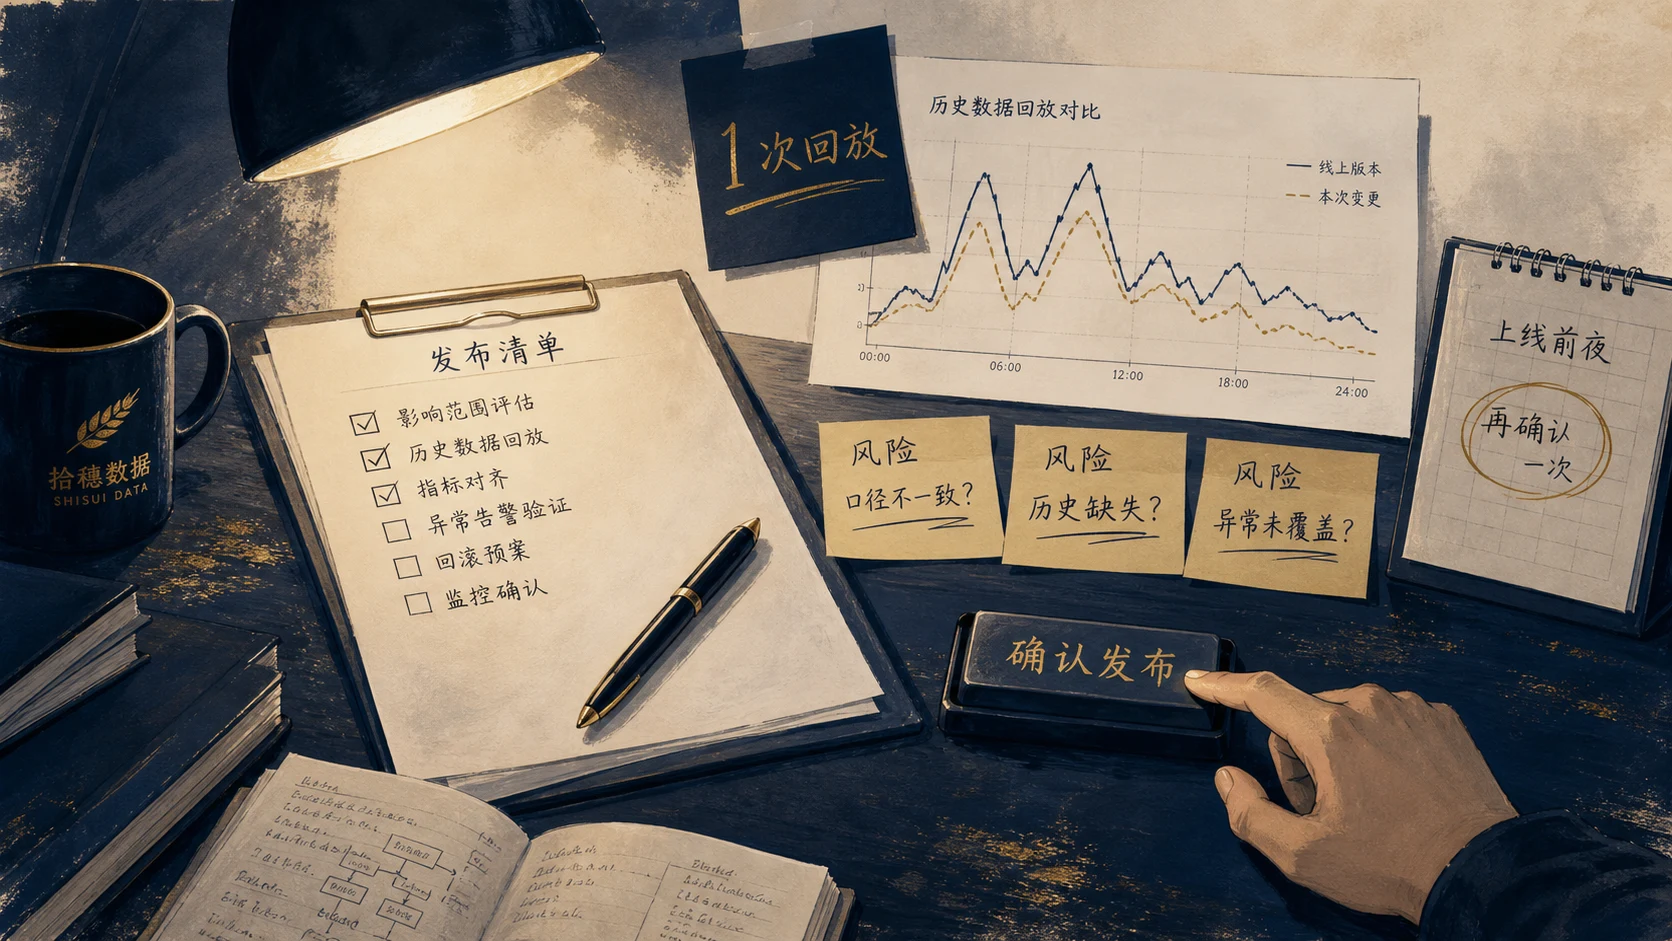
很多数据分析师和数据开发上线指标、SQL、模型或同步任务前,只用几条干净样本测试,结果上线后才被历史边界数据打脸。Stripe 用 Apache Spark 做历史流量回放测试提供了一个启发:普通数据从业者也可以在上线前多重放 1 次真实历史数据,提前发现口径、异常和兼容问题。
Spark 任务跑了 3 小时,别急着问 AI 怎么调参
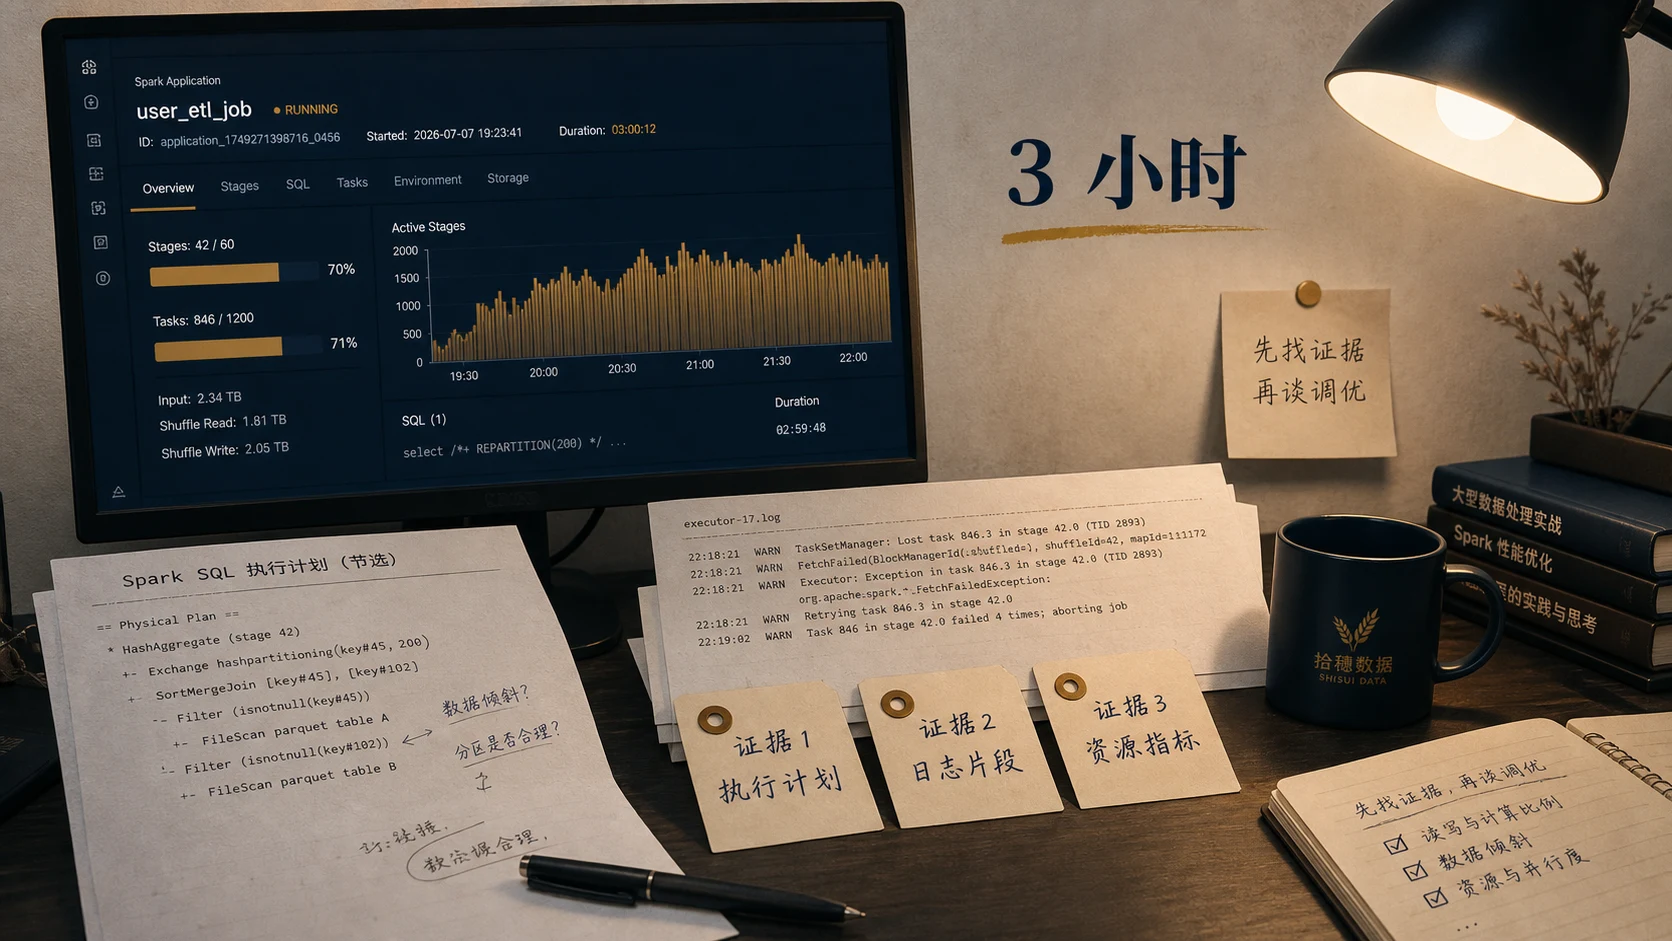
Spark 任务跑了 3 小时,很多数据开发第一反应是问 AI 要不要改 executor、shuffle、分区数。但慢任务不是靠一句调参解决的。本文结合 Expedia 分析 Spark SQL Plan 的实践,说明普通数据开发为什么要先拿出执行计划、运行指标和业务上下文这 3 份证据。
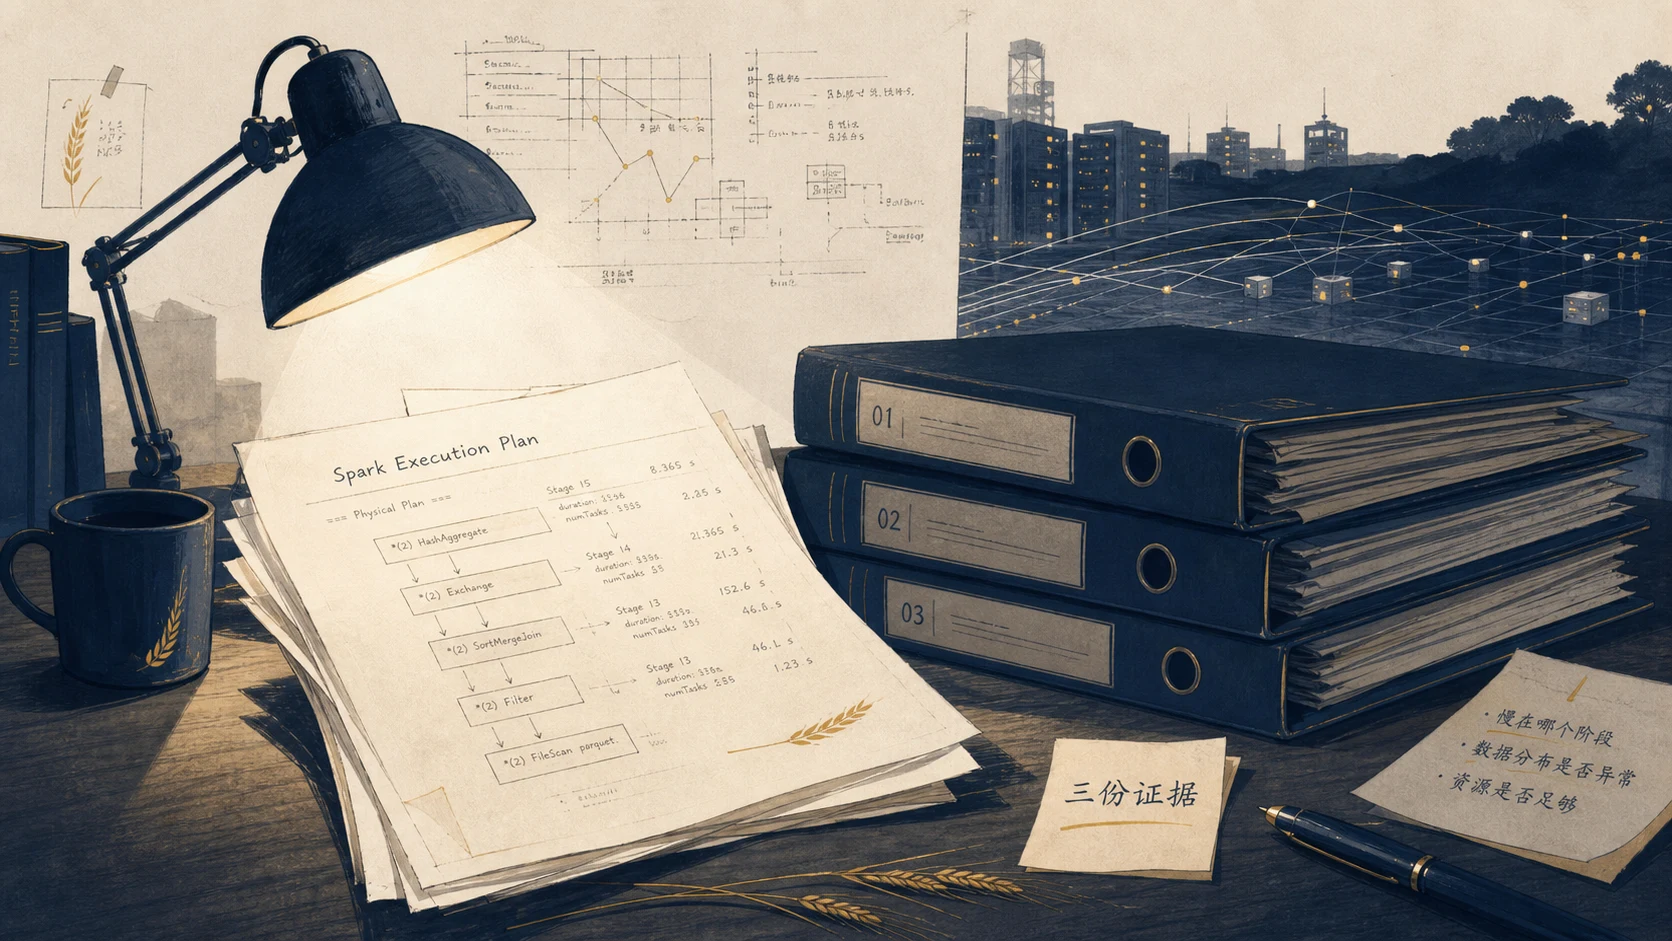
数据周刊|AI 已经会查 Spark 慢任务了,但它先问你要 3 份证据
本期数据周刊关注 Data Engineering Weekly #277:Databricks Lakebase、Meta AI Storage、Expedia 诊断 Spark SQL Plan、Stripe 重放历史流量。对数据分析师、BI 和数据开发来说,为什么 AI 能帮忙之前,先要准备 3 份证据?
数据周刊|2026年6月第4周:语义层、治理台、拒答能力
本期数据周刊关注 6 月最后一周的 5 个信号:Power BI 把语义模型接到 AI 应用,Databricks 继续强化 Unity Catalog 治理,MIT 讨论 GenAI 语义层,Lyft 公开指标语义层实践,Shopify 训练 AI 拒答。数据分析师和数据工程师该准备什么?
数据周刊|2026年6月第3周:Claude 问数、Agent 检索、数据抽象层
本期数据周刊关注 Data Engineering Weekly #274 里的 5 个信号:Anthropic 的 Claude 自助分析、Airbnb 多产品数据架构、Uber 数据抽象层、LinkedIn Agent 语义检索,以及 Capital One 的 DataAgents。AI 数据产品真正缺的是什么?
48 小时修完数据事故,真正该补的不是告警
一次数据事故从周五晚上拖到周日,团队 48 小时修完任务、补跑数据、恢复看板,但复盘时才发现真正缺的不是告警,而是影响面、修复记录、责任边界和上线验证。本文用 5 个问题拆解数据事故复盘,帮数据开发和数据治理团队避免下次重复摔在同一个地方。
数据周刊|2026年6月第2周:Flink 账单、ClickHouse 瓶颈、Agent 成本
本期数据周刊关注 4 个生产信号:Gorgias 的 Flink 账单系统、Cloudflare 的 ClickHouse 查询计划瓶颈、Netflix 的 Cassandra 时间序列分区,以及 Snowflake Summit 后的数据团队 Agent 成本讨论。数据工程师该从这些案例里看到什么?